La torta avvelenata: minacce all’AI e responsabilità condivisa
Cinque strati, dall’energia alle applicazioni, per localizzare le minacce all’AI. Incrociati con API, GPU a noleggio e on-prem, mostrano come si ripartisce la responsabilità condivisa.
Un modello a strati per le minacce all’AI e la gestione della responsabilità condivisa
Gran parte dei framework di sicurezza per l’AI si concentra sul livello applicativo: prompt, agenti e output dei modelli. Eppure l’AI moderna poggia su uno stack fisico e industriale fatto di energia, silicio, infrastruttura e modelli, ciascuno con le proprie caratteristiche e vulnerabilità.
Questo articolo sostiene due tesi. La prima è che la “torta a cinque strati” (energia, chip, infrastruttura, modelli, applicazioni) è uno schema pratico per localizzare le minacce all’AI, perché dà a ogni rischio un indirizzo e rende visibile come i guasti in basso nello stack si propaghino verso l’alto.
La seconda è che lo stesso schema, incrociato con i tre modi più comuni di usare l’AI (API, GPU a noleggio, on-prem), mostra quali rischi un’organizzazione deve presidiare direttamente, quali può solo governare attraverso i fornitori e dove la responsabilità è condivisa.
Per ogni strato descriviamo il contesto di mercato ed individuiamo minacce prioritarie (motivate anche attraverso incidenti documentati). Leggiamo poi la matrice di responsabilità che ne risulta alla luce della normativa europea (AI Act, NIS2 e DORA) e chiudiamo con tre passi pratici.
Introduzione
Nel panorama della analisi sulla sicurezza dell’AI, la vasta maggioranza dei framework si concentra sul livello applicativo e, in misura minore, sul modello. Ciò trova giustificazione se si considera che il meccanismo di fruizione dei modelli di frontiera è essenzialmente legato all’uso di GUI o API o similari; tutto ciò che sta sotto l’applicazione è un problema del provider.
Due forze stanno ora spingendo a far girare modelli propri su infrastrutture noleggiate o di proprietà, specialmente in area europea.
La prima è il costo: il prezzo per token continua a scendere, ma gli agenti consumano molti più token per task. Gartner per esempio prevede che il costo di inferenza per workflow agentico aumenterà di oltre cinque volte entro il 2028 [1].
La seconda è la sovranità: GDPR, DORA e NIS2 rendono verificabili la localizzazione dei dati e il controllo sui fornitori, e per un modello che tratta dati dei clienti è molto più semplice dimostrare dove si trovano i dati, e chi può raggiungerli, su un’infrastruttura che si controlla direttamente.
Questi driver spingono per una strategia di consumo dei servizi AI dove il vecchio modello verrà affiancato dagli approcci “on-prem” o “GPU rented” per la gestione dei dati sensibili e più strategici per l’organizzazione.
Tali considerazioni sollevano due domande, alle quali il presente articolo tenta di dare risposta: dove si trovano davvero le minacce all’AI lungo l’intero stack? E, per un dato modo di usare l’AI, chi ha la responsabilità di mitigare i rischi derivanti da tali minacce?
Un modello a strati del rischio AI
Il CEO di NVIDIA, Jensen Huang, ha descritto l’industria dell’AI come una torta a cinque strati. L’intenzione originale della metafora era indirizzato a sottolineare la rilevanza industriale dell’evoluzione dell’intelligenza artificiale, e come essa non si limiti al puro livello applicativo.
Riteniamo che tale visualizzazione sia utile anche per discutere di sicurezza e rischio AI; pertanto la adotteremo come schema analitico, con gli strati numerati dal basso:
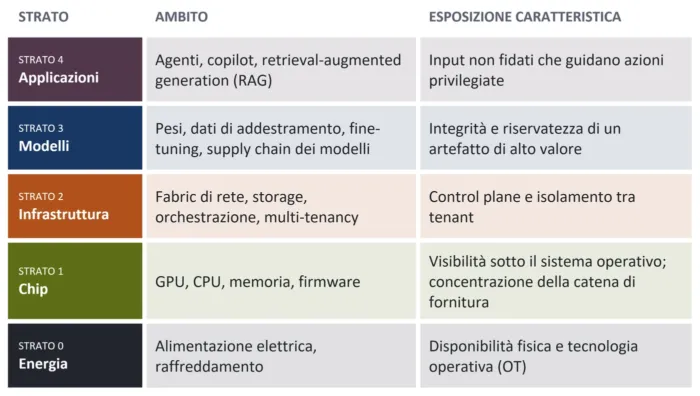
Lo schema dà un indirizzo a ogni minaccia, obbligando il threat model a considerare strati che altrimenti ignorerebbe, e rende esplicito che dipendenza ed impatti vanno dal basso verso l’alto.
Per ogni strato descriviamo brevemente il contesto e selezioniamo tre minacce che siano specifiche dell’AI, o da essa amplificate, e su cui un’organizzazione possa agire, presidiando un controllo o governando un fornitore.
Le minacce lungo lo stack AI
Strato 0 – Energia: la disponibilità diventa superficie d’attacco
A fine 2025 negli Stati Uniti erano operativi oltre 50 GW di data center, con una taglia media dei nuovi impianti passata da 25 MW nel 2020 a quasi 80 MW [2]. La rete non tiene il passo: un campus si costruisce in 18–36 mesi, mentre linee e sottostazioni richiedono anni, e in Virginia l’allacciamento può richiedere fino a sette anni [3].
Il panorama europeo ha numeri ridotti ma proporzioni similari tra tempi di costruzione dei data center ed adeguamento della rete.
Concentrazione. Quando un campus assorbe centinaia di megawatt da una sola sottostazione, un guasto spegne tutte le GPU di tutti i tenant nello stesso momento; chi noleggia capacità in una sola region eredita il single point of failure del fornitore.
Squilibrio di rete. I cluster AI sono tra i carichi più grandi e più rapidi della rete: un addestramento sincrono produce oscillazioni di potenza che, se coincidono con le frequenze critiche della rete, possono danneggiarne le infrastrutture [4].
Il 10 luglio 2024, in Virginia, un guasto su una linea a 230 kV ha fatto staccare contemporaneamente circa 1.500 MW di carico di circa 60 data center [5], e nel maggio 2026 la NERC ha emesso un’allerta di livello 3, il suo livello più alto, sui grandi carichi computazionali [6].
La ricerca mostra che lo stesso effetto può essere provocato deliberatamente, commutando in sincrono carichi ad alta potenza [7]: per ora solo in simulazione, ma incidenti analoghi ne hanno dimostrato l’applicabilità.
Raffreddamento come vettore d’attacco. I rack sopra i 100 kW hanno secondi di margine termico, e i sistemi che controllano pompe, chiller e quadri elettrici usano spesso protocolli senza autenticazione.
Nel dicembre 2025 oltre 30 impianti eolici e solari polacchi e una centrale di cogenerazione sono stati colpiti con malware wiper rivolto ai controller, entrando da dispositivi vulnerabili (credenziali di default e MFA assente) [8]. Le stesse classi di controller gestiscono alimentazione e raffreddamento dei data center GPU.
Strato 1 – Chip: la fiducia finisce sotto il firmware
Lo strato poggia su due colli di bottiglia: TSMC detiene circa il 73% del mercato delle fonderie di silicio [9] e ASML è l’unico fornitore di macchine per litografia EUV [10].
Packaging avanzato e memoria HBM sono esauriti per mesi [11], e i controlli all’export hanno alimentato un mercato parallelo: nel 2026 dirigenti legati a Supermicro sono stati incriminati per aver dirottato in Cina server AI acquistati tramite il Sud-est asiatico [12].
Monocoltura. Pochi progetti e una sola fonderia sono alla base di quasi tutto il calcolo AI: un difetto di progettazione raggiunge tutti i provider insieme, e il multi-cloud diversifica i provider, non il silicio.
Firmware invisibile. BMC e firmware delle GPU stanno sotto il sistema operativo, fuori dalla vista dell’EDR; una compromissione sopravvive alla reinstallazione e, sull’hardware a noleggio, può passare da un tenant al successivo.
Nel giugno 2025 la CISA ha confermato lo sfruttamento della CVE-2024-54085 nel firmware BMC MegaRAC di AMI, presente nei server HPE, Asus e ASRock forniti ai cloud provider [13].
Fuga dal container. I componenti che collegano i container alle GPU girano con privilegi di host. NVIDIAScape (CVE-2025-23266) permetteva di ottenere root sull’host con un Dockerfile di tre righe, e circa il 37% degli ambienti cloud usava versioni vulnerabili [14].
Strato 2 – Infrastruttura: il premio è il control plane
Nel 2026 la spesa in cloud per l’inferenza ha superato quella per l’addestramento [15]: l’infrastruttura AI diventa un servizio sempre attivo su dati in produzione. Crescono i neocloud come CoreWeave, Nebius e l’europea Nscale [16]; anche un cluster dedicato condivide però control plane, firmware e stack software del provider.
Orchestratore come domain controller. Orchestratori per workload AI come Ray, Slurm, Kubeflow e Jupyter eseguono codice su ogni nodo e spesso nascono senza autenticazione.
Nel novembre 2025 la campagna ShadowRay 2.0 ha dirottato cluster Ray esposti per cryptomining e DDoS, con oltre 230.000 server raggiungibili da internet [17]; nell’agosto 2026 la CISA ha inserito un’altra falla di Ray tra quelle sfruttate attivamente [18].
Storage e token. Dati, checkpoint e pesi sono spesso protetti da token di accesso troppo permissivi e da chiavi trapelate: è la via d’ingresso più comune e non richiede attacchi esotici. Un checkpoint manomesso, inoltre, riporta in vita una backdoor al ripristino del modello.
Fabric invisibile. Il traffico GPU-GPU su InfiniBand e RoCE bypassa il kernel, e firewall ed EDR basati sull’host non lo vedono; su un AI fabric condiviso il partizionamento è l’unica separazione tra tenant. Gli attacchi sono stati dimostrati in ricerca [19], non ancora sul campo, ma non sembrano particolarmente complessi in assenza di controlli integrativi.
Strato 3 – Modelli: l’artefatto è la superficie d’attacco
I modelli open-weight sono in media tre-quattro mesi indietro rispetto a quelli di frontiera [20], e in Europa è soprattutto la conformità normativa a spingere verso soluzioni sovrane: la indica come ragione principale per prediligere soluzioni locali il 48% delle organizzazioni [21].
Pochi modelli girano come vengono rilasciati: fine-tuning e quantizzazione creano nuovi file da proteggere.
Il modello è codice. I formati basati su formato Python pickle eseguono il proprio contenuto al caricamento, e un repository può includere codice di caricamento personalizzato. Su Hugging Face sono stati trovati oltre cento modelli in grado di eseguire codice, e gli scanner vengono aggirati di continuo [22].
Nel luglio 2026 agenti autonomi, durante una valutazione interna di OpenAI, hanno ottenuto sempre su Hugging Face privilegi di cluster-admin e token con accesso in scrittura al codice sorgente [23].
Poisoning che non si diluisce. Circa 250 documenti avvelenati sono bastati a impiantare una backdoor in modelli da 600 milioni a 13 miliardi di parametri, e il numero non è cresciuto con la dimensione del modello, contrariamente a quanto ci si aspetterebbe [24]. La backdoor testata era semplice, ma il risultato smentisce l’idea che il numero di documenti infetti scali con la dimensione del modello.
I pesi sono “crown jewels”. Chi ha il file ha il modello, senza filtri, monitoraggio e limiti d’uso del provider.
Per la maggior parte delle organizzazioni l’asset a rischio è il proprio fine-tuning: i pesi incorporano i dati con cui è stato addestrato, ed è stato dimostrato che da un modello si possono estrarre dati di addestramento, compresi dati personali. Perdere i pesi può significare quindi anche perdere i dati.
Ogni copia affidata a un fornitore, a un integratore o a un consulente è un punto di fuga: nel 2024 un modello di Mistral è trapelato proprio dal lato di un cliente in accesso anticipato [25].
Strato 4 – Applicazioni: ogni documento è un’istruzione
Gli agenti… agiscono: MCP è diventato lo standard per collegarli agli strumenti, con oltre 10.000 server attivi a fine 2025 [26].
RAG e connettori portano in ogni prompt contenuti da SharePoint, Slack e Confluence, e una finestra da un milione di token può contenere centinaia di documenti in una sola richiesta: nessuno verifica cosa ci finisce dentro, il modello stesso diventa meno accurato nel trovare e collegare le informazioni rilevanti [27].
Ogni documento è un’istruzione. Un testo nascosto in una email o in una pagina web scavalca il prompt di sistema, e la risposta del modello può esporre dati sensibili. Con EchoLeak (giugno 2025) una sola email ha fatto esfiltrare dati da Microsoft 365 Copilot [28]; nel 2026 la prompt injection indiretta è stata osservata sul campo contro agenti AI [29].
Agenti con i tuoi permessi. Un’istruzione iniettata, o una decisione sbagliata dell’agente stesso, diventa un’esecuzione irreversibile, come ad esempio un database cancellato: nel 2025 un agente di Replit lo ha fatto durante un code freeze, senza alcun attaccante [30].
I permessi definiscono il raggio d’esplosione, e un prompt, per quanto dettagliato e prescrittivo, non è un controllo. Le skill degli agenti sono una nuova supply chain: su ClawHub ne sono state trovate 341 malevole su 2.857 [31].
Oversharing esposto. Le pipeline RAG perdono spesso i permessi dei documenti d’origine; al contrario i copilot aziendali li rispettano, e proprio per questo fanno emergere ciò che era condiviso anche erroneamente. Il 40% delle organizzazioni ha rinviato Copilot di almeno tre mesi per questo motivo [32]. Due facce della stessa medaglia, per cui processi e metadata su controllo dell’accesso rimangono elementi critici del trattamento del dato in pipeline AI.
Gli strati come modello di minaccia
In sintesi, tre schemi attraversano gli strati: la concentrazione (poche utility, chip, firmware, orchestratori e hub sotto quasi tutte le installazioni), i punti ciechi (firmware, fabric e OT fuori dalla telemetria di sicurezza) e i confini di isolamento che si spostano (un toolkit GPU o uno scheduler al posto dell’hypervisor).
Nessuno è visibile dal solo livello applicativo, che si focalizza sugli schemi noti di controllo dell’accesso, verifica di input e output, integrità del dato etc.
La responsabilità nei diversi modelli di deployment
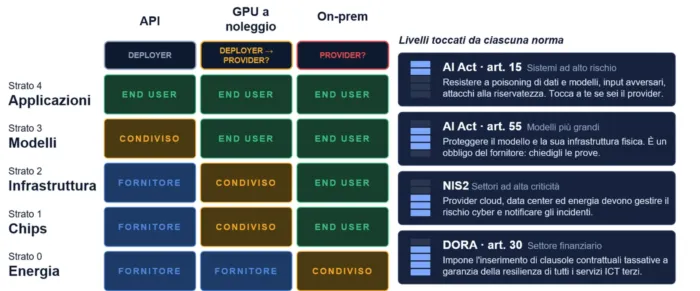
Ciò che un’organizzazione può fare per ciascuna minaccia dipende da come usa l’AI.
Distinguiamo tre modelli:
- API: si chiama un modello frontier via internet; vi rientrano anche Copilot e ChatGPT Enterprise, accesso GUI etc,
- GPU a noleggio: il proprio modello su un hyperscaler, un neocloud o un cloud sovrano, e
- on-prem fully managed: il proprio modello sui propri rack.
Incrociandoli con i cinque strati, ogni cella ricade in una di tre categorie: Fornitore (blu), che l’organizzazione governa con contratti, SLA ed evidenze;
End User (verde), che presidia con controlli propri;
Condiviso (giallo), che prefigura una responsabilità ricadente su entrambe le parti.
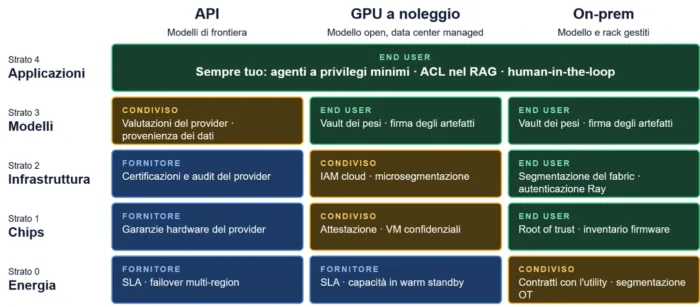
Lo strato applicativo è sempre dell’organizzazione, e più ci si sposta verso destra, più in basso arriva la sua responsabilità: l’organizzazione governa il rischio di ciò che noleggia, tratta il rischio di ciò che gestisce direttamente.
In questo senso il modello non differisce dal più noto modello di responsabilità condivisa della sicurezza nella fruizione dei servizi cloud.
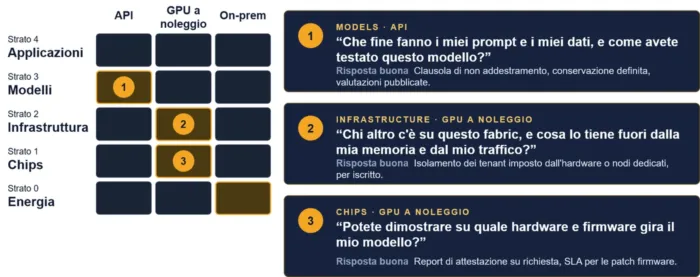
Le celle condivise richiedono particolare cautela, poiché ciascuna parte tende a presumere che il controllo sia in carico all’altra. Ognuna di esse può diventare una domanda per il fornitore, da porre prima di firmare:
Una lettura normativa del modello: il caso europeo
Il modello a strati è funzionale all’analisi di responsabilità anche ai fini della normativa europea cogente in materia di sicurezza ed impiego dell’intelligenza artificiale; si possono usare colonne e righe della matrice per interpretare differenti aspetti dell’analisi di rischio e delle relative competenze.
Le colonne mappano il ruolo giuridico
Chi usa un modello tramite API è di norma un deployer ai sensi dell’AI Act europeo, con obblighi relativamente leggeri.
Chi mette il proprio nome su un sistema ad alto rischio, o lo modifica in modo sostanziale, può diventarne il provider (nel testo italiano, fornitore) ai sensi dell’articolo 25, e assume l’articolo 15, che chiede misure contro “gli attacchi che cercano di manipolare il set di dati di addestramento (data poisoning) o i componenti preaddestrati utilizzati nell’addestramento (model poisoning)”, contro gli esempi antagonistici e contro gli attacchi alla riservatezza [33].
Il ruolo segue ciò che si fa, non dove gira il modello; fine-tuning e hosting in proprio rendono il passaggio (e la relativa estensione di competenze e responsabilità) molto più probabile.
Le righe mappano gli strati impattati
L’articolo 15 copre la parte alta dello stack. L’articolo 55 obbliga i provider dei modelli con rischio sistemico a proteggere “il modello di IA per finalità generali con rischio sistemico e l’infrastruttura fisica del modello” [34]: un obbligo del fornitore, di cui il cliente può chiedere le evidenze.
NIS2 inserisce cloud, data center ed energia tra i settori ad alta criticità (i cui operatori più grandi sono soggetti essenziali) [35], e per il settore finanziario, il regolamento DORA impone un set di clausole contrattuali obbligatorie con i fornitori ICT, eliminando i semplici accordi di ‘best effort’ a favore di impegni precisi e verificabili [36].
Il Digital Omnibus ha rinviato gli obblighi per i sistemi ad alto rischio al dicembre 2027 e all’agosto 2028 [37], e la maggior parte dei copilot aziendali non è ad alto rischio. In Italia la legge 132/2025 designa l’ACN tra le due autorità nazionali per l’AI [38].
Nel complesso, gran parte della normativa ricade sui fornitori, e questo trasforma le celle da governare in obblighi di cui l’organizzazione può pretendere le evidenze.
Limiti
L’estensione rappresentativa qui proposta è una lente, non una tassonomia: alcuni confini sono sfumati, e abbiamo assegnato ogni minaccia allo strato in cui si trova il controllo principale.
Le evidenze sono disomogenee: sfruttamenti confermati (Polonia, MegaRAC, ShadowRay, Hugging Face), dimostrazioni corrette prima di abusi noti (EchoLeak, NVIDIAScape), eventi accidentali senza attaccante (Virginia, Replit) e risultati di ricerca (attacchi al carico, poisoning, fabric RDMA).
Infine, la matrice è un default e non un contratto: nodi dedicati, appliance gestite o colocation spostano le linee di demarcazione di responsabilità, che vanno verificate fornitore per fornitore.
Pertanto, il modello non ambisce a sostituire un approccio formalizzato di gestione del rischio, che è invece necessario e fondamentale in ogni ambito di governance del rischio AI. Al contrario, agisce come complemento comunicativo per facilitare la discussione interfunzionale e verso livelli apicali all’interno dell’organizzazione, e con partner e stakeholder della supply chain all’esterno.
Conclusioni e raccomandazioni
La sicurezza dell’AI non può fermarsi al prompt. Le minacce si estendono anche ai livelli sotto l’applicazione, e man mano che le organizzazioni passano dalle API all’hosting in proprio, la loro quota di responsabilità nella gestione della sicurezza dello stack si amplifica, così come aumentano le aree di competenza condivisa con i fornitori.
Tre passi, in ordine crescente di impegno:
Disegnare la torta (questa settimana): produrre un elenco comprensivo di ogni servizio AI in uso, il suo modello di deployment e gli strati che tocca.
Colorare la griglia (questo mese). Per ogni servizio e strato, indicare se è di responsabilità del fornitore, condiviso o in capo all’organizzazione, e verificare la posizione ai fini della caratterizzazione regolatoria (deployer o provider).
Caratterizzare il giallo (al prossimo rinnovo). Ogni cella riferita a responsabilità condivisa deve essere formalmente definita in termini di matrice RACI. In assenza di tali evidenze, ogni gap deve essere una domanda per il fornitore, e ogni risposta diventa una clausola contrattuale al prossimo rinnovo.
Incontra SANS Institute e Silvano Sogus al Forum ICT Security 2026
Silvano Sogus, autore di questo articolo e istruttore SANS, insegna nel corso LDR519 dedicato a governance, rischio e conformità nella cybersecurity. Con oltre 25 anni di esperienza, contribuisce alla missione di SANS Institute: sviluppare le competenze di cybersecurity attraverso formazione pratica e risorse curate da professionisti del settore.
Sarà al Forum ICT Security 2026, mercoledì 18 novembre dalle 10:40 alle 11:00, con l’intervento «La torta avvelenata: panorama delle minacce nello stack AI e mitigazione del rischio», nel quale approfondirà i temi dell’articolo e le misure concrete per gestire tali rischi. Il team di SANS Institute sarà inoltre a disposizione presso lo stand per confrontarsi sulle sfide di sicurezza e sulle esigenze formative della vostra organizzazione.
Riferimenti
- VentureBeat, Gartner says agent costs will rise fivefold by 2028 even as tokens get cheaper, ottobre 2026, sul comunicato Gartner del 17 agosto 2026. ↑
- Utility Dive, 50 GW of data centers online at end of 2025, with MISO seeing strongest growth: FERC, marzo 2026. ↑
- Bloomberg, Data Centers Face Seven-Year Wait for Power Hookups in Virginia, agosto 2024. ↑
- E. Choukse et al., Power Stabilization for AI Training Datacenters, arXiv, agosto 2025. ↑
- NERC, Incident Review: Considering Simultaneous Voltage-Sensitive Load Reductions, gennaio 2025; Reuters, articolo ripreso da Insurance Journal, marzo 2025. ↑
- NERC, Level 3 Alert – Essential Action to Industry: Computational Load Modeling, Studies, Instrumentation, Commissioning, Operations, Protection, and Control, 4 maggio 2026. ↑
- S. Soltan, P. Mittal, H. V. Poor, BlackIoT: IoT Botnet of High Wattage Devices Can Disrupt the Power Grid, USENIX Security 2018. ↑
- The Hacker News, CERT Polska details coordinated cyber attacks on 30+ wind and solar farms, gennaio 2026. ↑
- Counterpoint Research, quote di mercato delle fonderie, secondo trimestre 2026, agosto 2026; si veda anche TrendForce, settembre 2026. ↑
- ASML, Busting ASML myths, 2022. ↑
- The Register, risultati Micron del quarto trimestre fiscale 2025, settembre 2025; si veda anche Futurum, dicembre 2025. ↑
- U.S. Attorney’s Office, Southern District of New York, Three Charged With Conspiring To Unlawfully Divert U.S. Artificial Intelligence Technology To China, 19 marzo 2026. ↑
- BleepingComputer, CISA: AMI MegaRAC bug enabling server hijacks exploited in attacks, giugno 2025. ↑
- Wiz Research, NVIDIAScape (CVE-2025-23266), luglio 2025. ↑
- Gartner, Gartner Forecasts Worldwide AI-Optimized IaaS Spending to Grow 96% in 2026, agosto 2026. ↑
- The Next Web, articolo su Nscale e il contratto con Microsoft a Sines, maggio 2026. ↑
- The Hacker News, ShadowRay 2.0 exploits unpatched Ray flaw, novembre 2025; si veda anche Oligo Security. ↑
- The Hacker News, CISA flags actively exploited Ray flaw, agosto 2026. ↑
- B. Rothenberger et al., ReDMArk: Bypassing RDMA Security Mechanisms, USENIX Security 2021. ↑
- Epoch AI, confronto tra modelli open-weight e closed-weight, ottobre 2025; divario di capacità tra modelli aperti e chiusi, maggio 2026. ↑
- Accenture, Europe seeking greater AI sovereignty, Accenture report finds, novembre 2025. ↑
- The Hacker News, Malicious ML models on Hugging Face leverage broken pickle format, febbraio 2025. ↑
- Hugging Face, Anatomy of a frontier lab agent intrusion: technical timeline of the July 2026 incident, 2026. ↑
- Anthropic, UK AI Security Institute, Alan Turing Institute, A small number of samples can poison LLMs of any size, ottobre 2025. ↑
- VentureBeat, Mistral CEO confirms leak of new open-source AI model, febbraio 2024. ↑
- Model Context Protocol, MCP joins the Agentic AI Foundation, dicembre 2025. ↑
- A. Modarressi et al., NoLiMa: Long-Context Evaluation Beyond Literal Matching, ICML 2025. ↑
- EchoLeak: The First Real-World Zero-Click Prompt Injection Exploit in a Production LLM System, 2025. ↑
- Palo Alto Networks Unit 42, Fooling AI Agents: Web-Based Indirect Prompt Injection Observed in the Wild, marzo 2026. ↑
- Fortune, l’agente di Replit cancella un database di produzione, luglio 2025. ↑
- The Hacker News, Researchers find 341 malicious ClawHub skills, febbraio 2026. ↑
- Computerworld, Microsoft 365 Copilot rollouts slowed by data security, ROI concerns, settembre 2024. ↑
- Regolamento (UE) 2024/1689 (AI Act), articolo 15, testo italiano (AI Act Service Desk, Commissione europea). ↑
- Regolamento (UE) 2024/1689 (AI Act), articolo 55, testo italiano (AI Act Service Desk, Commissione europea). ↑
- Direttiva (UE) 2022/2555 (NIS2). ↑
- Regolamento (UE) 2022/2554 (DORA). ↑
- Usercentrics, EU AI Act deal: Digital Omnibus now in force, 2026; si veda anche Gibson Dunn. ↑
- Squire Patton Boggs, Italian Law No. 132/2025. ↑
Contenuto realizzato in collaborazione con SANS Institute.